无需联网,无需高配电脑?基于C++的极速本地AI生图实践
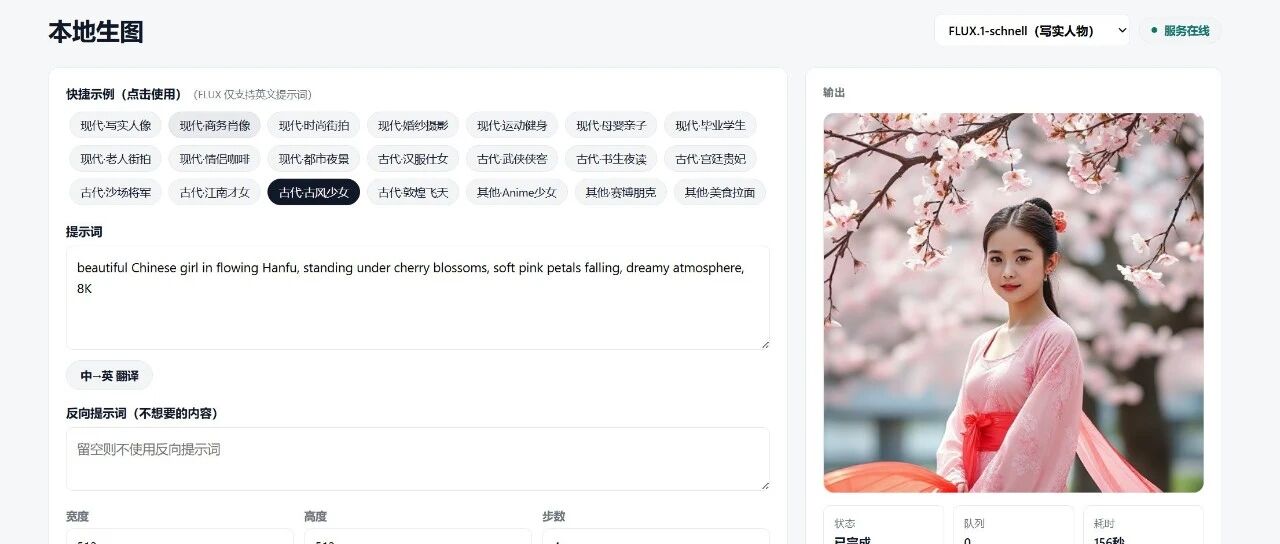
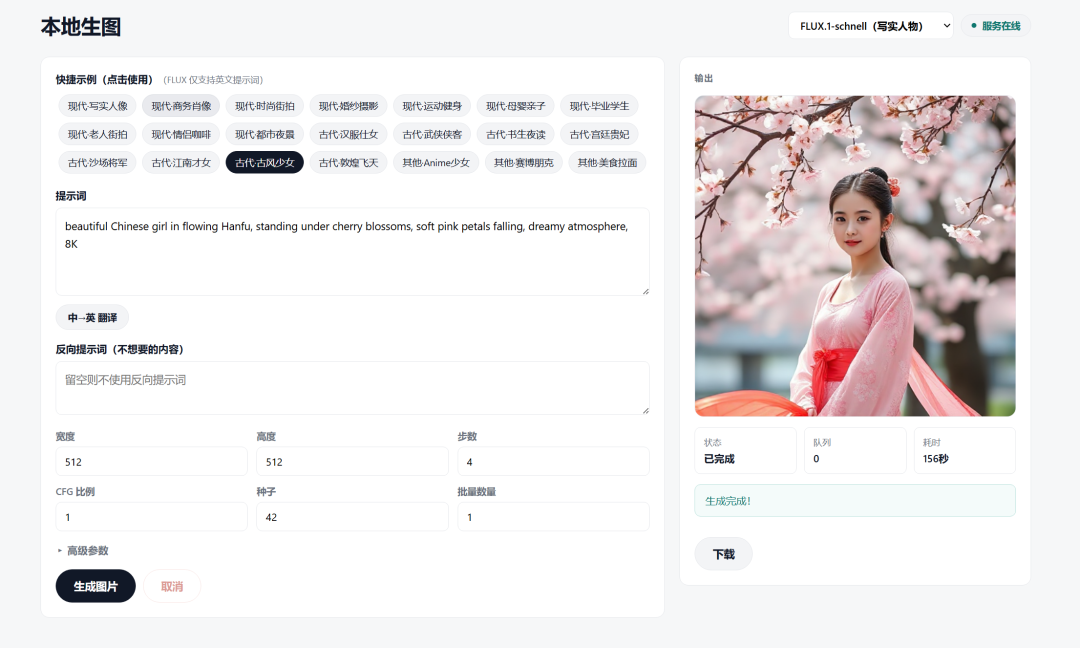
基于 stable-diffusion.cpp 的本地图片生成方案,支持 FLUX.1-schnell(写实人物)和 Z-Image-Turbo(中文优化)双模型。 纯 C/C++ 推理,无需 Python 环境,支持中英文提示词,数据全程本地不上传。
硬件环境
本方案支持自动适配不同配置的电脑,启动时自动探测 GPU 类型与显存模式。
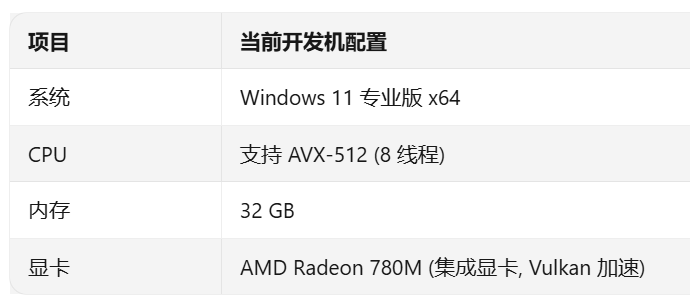
换电脑无需改配置:首次启动自动探测硬件并写入 config.json,按"集显/独显/CPU"三种模式自动选择最优后端参数。
目录结构
d:\llamafile\
├── sd-cli.exe
# 命令行生图工具
├── sd-server.exe
# Web UI 服务端
├── zimage-webui.exe
# Go Web UI 主程序(含硬件探测)
├── ggml-vulkan.dll
# Vulkan 后端 (780M 加速)
├── ggml-cpu-*.dll
# CPU 后端 (各指令集)
├── generate.bat
# 命令行生图脚本 (自动适配)
├── generate-flux.bat
# FLUX 命令行生图脚本 (自动适配)
├── config.json
# 硬件探测缓存(首次启动自动生成)
├── README.md
# 本文档
├── models\
# 模型文件
│ ├── z_image_turbo-Q5_0.gguf
# Z-Image 扩散模型 (4.23 GB)
│ ├── Qwen3-4B-Instruct-2507-Q4_K_M.gguf
# Z-Image 文本编码器 (2.33 GB)
│ ├── flux1-schnell-q8_0.gguf
# FLUX.1-schnell 扩散模型 (6.41 GB)
│ ├── clip_l.safetensors
# FLUX.1 CLIP 文本编码器 (0.23 GB)
│ ├── t5xxl-Q4_K_M.gguf
# FLUX.1 T5XXL 文本编码器 (2.70 GB)
│ └── ae.safetensors
# VAE 解码器 (共用, 0.31 GB)
└── output\
# 生成的图片输出目录
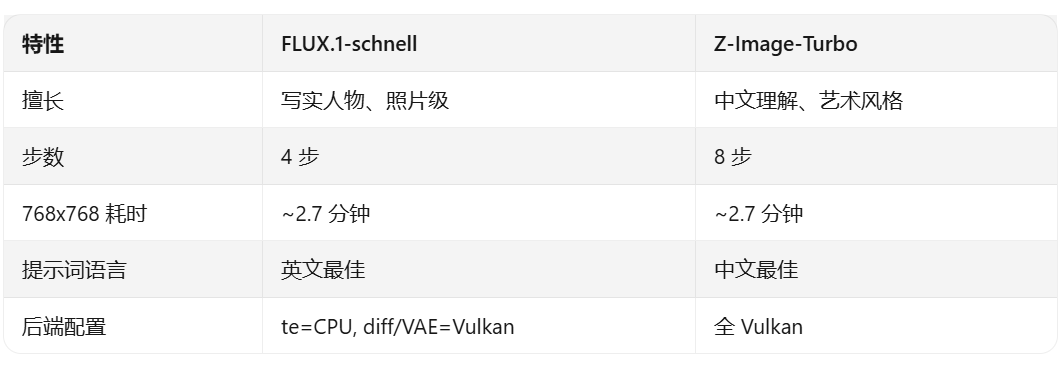
双模型对比
快速开始
方式一: Web UI (推荐)
双击桌面「Z-Image WebUI」快捷方式,选择模型后自动打开浏览器。按 Ctrl+C 停止服务。
方式二: 命令行生图
REM
FLUX.
1
-schnell (写实人物, 英文提示词)
generate
-flux.bat
"photorealistic portrait of a young woman, natural light"
generate
-flux.bat
"a businessman in suit, studio lighting"
768
768
4
42
REM
Z-Image-Turbo (中文优化)
generate
.bat
"一只橘猫坐在窗台上,阳光温馨"
generate
.bat
"赛博朋克城市夜景"
1024
1024
8
42
图片自动保存到 output\ 目录,文件名带时间戳。
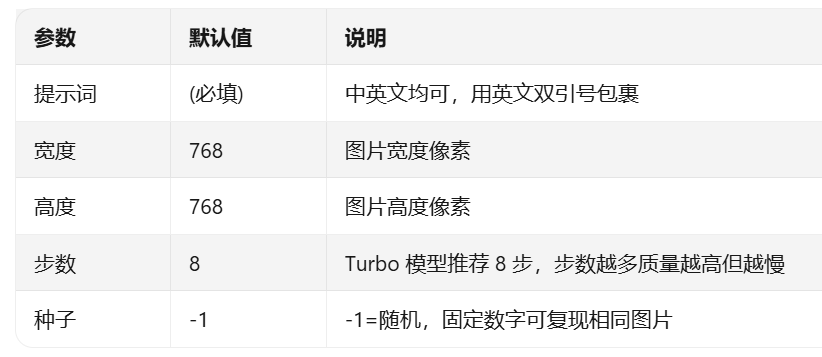
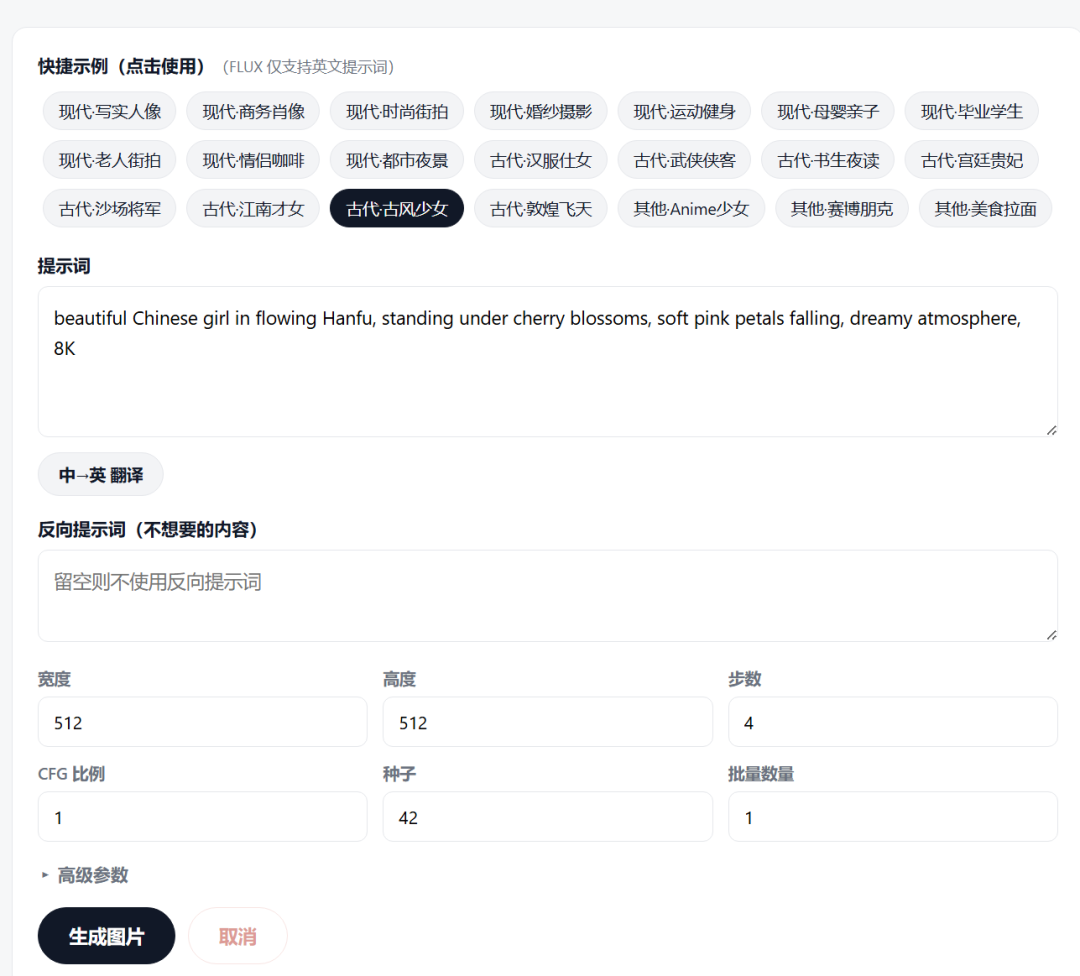
参数说明
后端配置说明
程序启动时自动探测硬件,按三种模式选择后端参数:
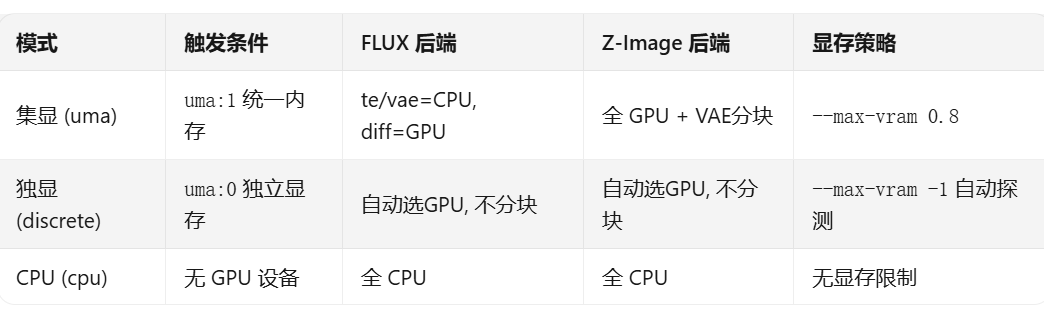
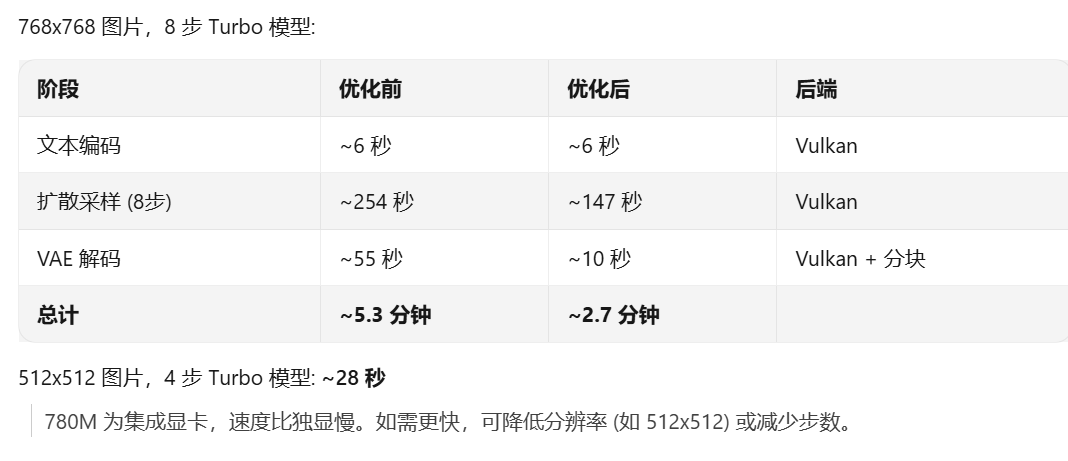
集显模式 VAE 分块解码 (--vae-tiling --vae-tile-size 64x64) 是关键优化: 不分块时 VAE 需 5.9GB 显存(集显不够会报错),分块后仅需 2GB, 可放回 GPU 运行,解码速度从 ~55 秒降到 ~10 秒。
硬件自动适配
工作原理
首次启动时,zimage-webui.exe 跑一次 sd-cli 探测,捕获 stderr 中的设备信息
解析 GPU 类型(Vulkan/CUDA)、设备名、uma 值(集显=1/独显=0)
按探测结果自动选择 uma/discrete/cpu 模式,生成对应后端参数
探测结果写入 config.json 缓存,后续启动直接读取(跳过探测)
config.json 说明
{
"hardware"
:
{
"has_gpu"
:
true
,
"gpu_type"
:
"vulkan"
,
// vulkan | cuda | ""
"device_count"
:
1
,
"is_uma"
:
true
,
// true=集显, false=独显
"device_name"
:
"AMD Radeon 780M Graphics"
,
"detected_at"
:
"2026-07-04T12:55:58+08:00"
},
"profile"
:
"auto"
// auto | cpu | uma | discrete
}
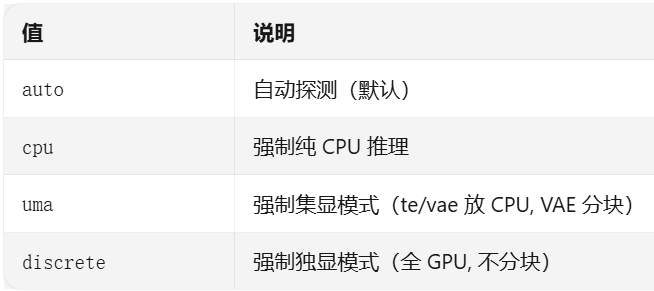
手动 override
如自动探测结果不理想,可直接编辑 config.json 的 profile 字段:
性能参考
进阶: 更换量化版本
如需更高画质,可下载 Q8_0 版本替换 (文件更大、速度更慢):
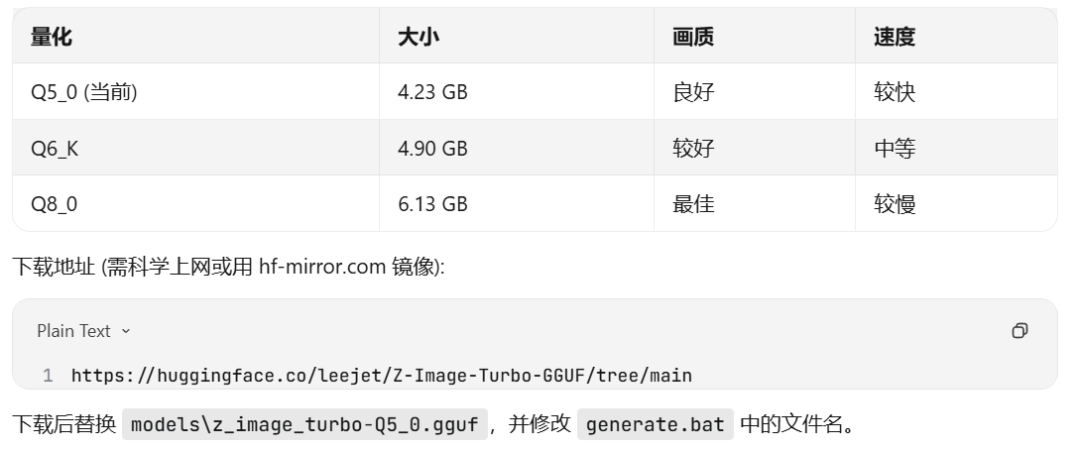
载后替换 models\z_image_turbo-Q5_0.gguf,并修改 generate.bat 中的文件名。
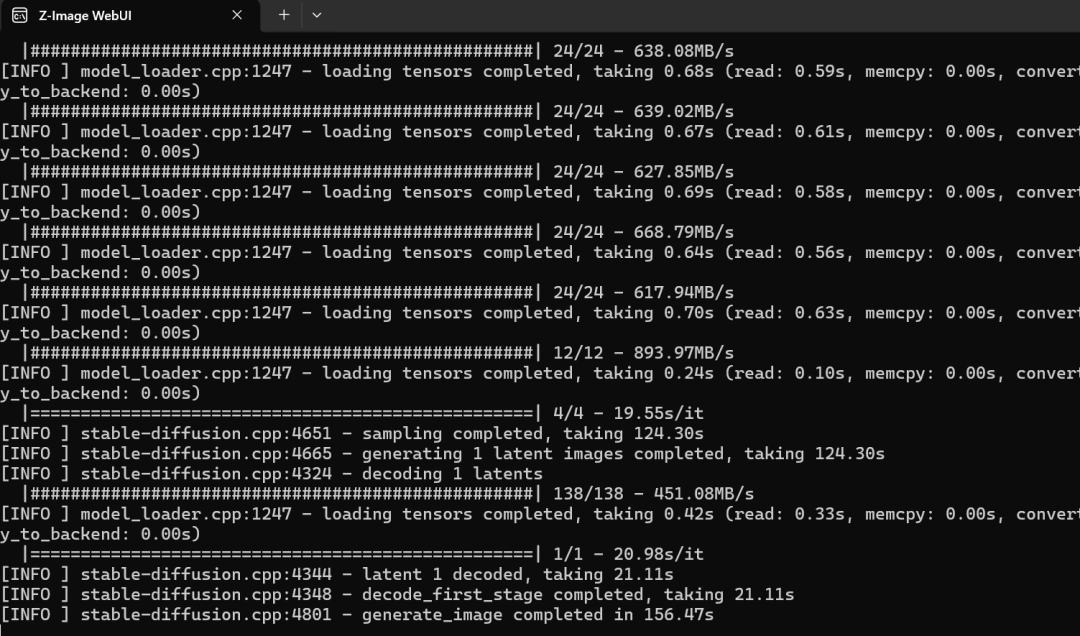
故障排查
Q: 提示 Vulkan 显存不足 (ErrorOutOfDeviceMemory) A: 集显模式下确认 config.json 的 profile 为 uma(会自动启用 VAE 分块)。若仍不足,可手动改为 cpu 模式走纯 CPU。
Q: 换了电脑后生图失败 / 报错 backend not found A: 删除 config.json 后重启,或运行 zimage-webui.exe --redetect 重新探测硬件。
Q: 独显机器速度不如预期 A: 检查 config.json 的 profile 是否为 discrete。若误判为 uma,手动改为 discrete 以禁用 VAE 分块。
Q: 生成速度太慢 A: 降低分辨率到 512x512,或减少步数。780M 集显性能有限;纯 CPU 模式更慢,建议有 GPU 时用 GPU。
Q: 模型加载失败 A: 检查 models\ 目录下三个文件是否完整:
z_image_turbo-Q5_0.gguf (应约 4.23 GB)
Qwen3-4B-Instruct-2507-Q4_K_M.gguf (应约 2.33 GB)
ae.safetensors (应约 0.31 GB)
Q: 提示词效果不好 A: Z-Image 对中文支持良好,也可尝试英文提示词。Turbo 模型用 --cfg-scale 1.0。
模型来源
扩散模型: Z-Image-Turbo (阿里巴巴通义实验室, Apache 2.0)
文本编码器: Qwen3-4B-Instruct-2507 (Apache 2.0)
VAE: FLUX.1-schnell ae (Apache 2.0)
推理引擎: stable-diffusion.cpp (MIT)
温馨提示
知识产权声明:本软件已获国家版权局软件著作权登记(登记号:2022SR0558725),受《计算机软件保护条例》保护。未经书面授权,严禁对本软件进行反向工程、反编译、破解或任何形式的篡改。侵权必究。
官方指引:本文档为官方安装部署说明,仅适用于当前发布版本,后续版本请以最新官方文档为准。
环境要求:安装前请确认操作系统版本、运行环境(如 .NET、Java 等)及硬件配置满足软件运行要求,避免因环境不兼容导致异常。
操作风险与免责:安装配置涉及防火墙、注册表或环境变量等系统级变更,建议由具备相关经验的技术人员操作。因用户未严格遵循本官方指引或操作不当导致的任何数据丢失、系统异常或其他损失,我方不承担相关责任。如遇问题,请及时联系技术支持。
反馈渠道:如有未覆盖的问题,欢迎通过客服反馈,我们将持续更新与改进。
版本记录:最后更新于 2026-08-22