从"改规则循环"到"零规则适配":PDF报关单解析V3升级记
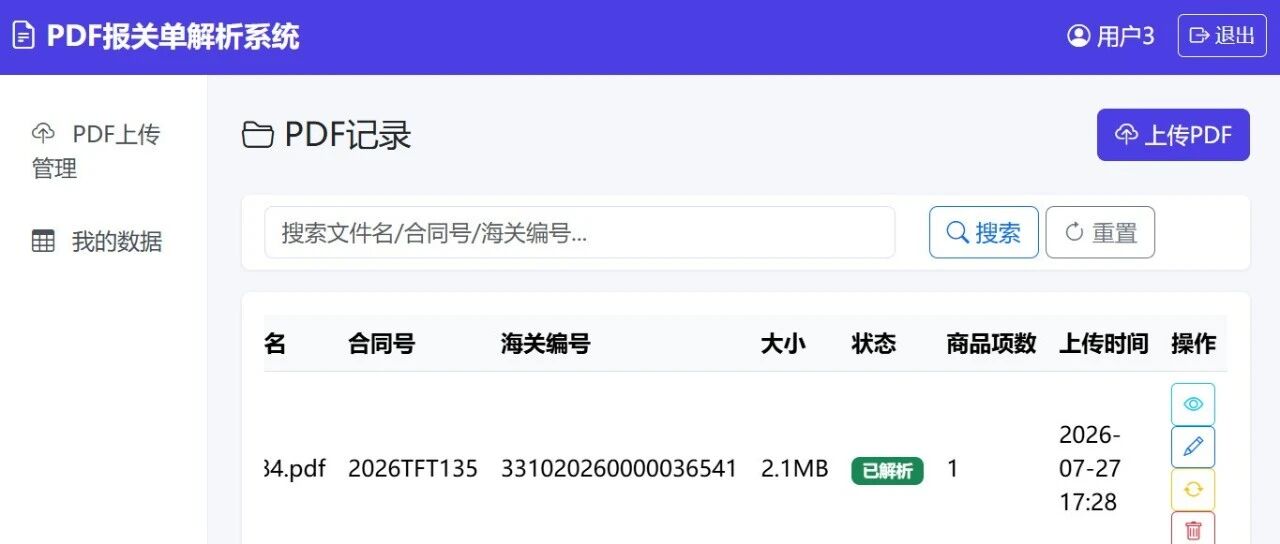
导语:上一篇文章介绍了Go重构版的AI主解析架构——AI从PDF原文独立提取,规则引擎降级为兜底。文章发出后,我们拿着它跑真实业务,很快又踩进一个熟悉的坑:每上传一批新PDF,就冒出几个字段不对,只能不断分析PDF去改规则。这篇就是破解这个循环的完整记录:一个关键洞察 + 三项改造,让系统从"新版式=改规则"变成"新版式=零适配"。
一、新版本上线,熟悉的配方又来了
V2版上线的第一个月,功能都在预期内:批量上传、AI解析、Excel导出,47份历史PDF全部通过。直到业务方开始传新的PDF。
"这批文件件数不对,全是1。""这批毛重和净重一样。""这个单子出口口岸怎么是'外港海关',我们要的是'外高桥'。"
每一条反馈,都对应一段代码改动——要么加一条规则,要么改一个正则。改完一批,过两周又来一批新格式,继续改。这和我们做Python版时的感受一模一样:规则是按旧版式写死的,只要新格式和旧版式不一样,规则就出错。
但V2不是已经"AI主解析"了吗?AI那么强,为什么还会错?
二、根因:规则引擎还在生产链里
带着疑问,我们做了两件事:一是把108份PDF全部跑一遍,二是把AI的原始返回和最终结果逐字段对比。
对比结果让人意外。AI的原始返回其实相当不错:商品名称、境内货源地、指运港这些"文本内容字段",AI基本都对。真正的问题出在数值字段上:
字段
AI常见错误
规则结果
件数
返回"1"(把表体项数当件数)
正确(如716/1041)
毛重
和净重一样(混淆两个数字)
正确
申报日期
取成出口日期
正确
总价
取成境内货源地代码32259
错误(规则"取最大数字"被污染)
关键就在这里:V2的合并策略是"AI空字段用规则补全,易错字段规则优先覆盖"。出发点是好的——规则在数值字段上更可靠,用它兜底。但规则是按旧版式写死的,只要规则参与生产,新版式一进来,规则自己的错误就会"补全"进最终结果。
规则引擎以为自己在帮忙,实际上是个"好心办坏事"的角色:AI对了它覆盖成错的,AI空了它填上错的。
三、关键洞察:字段要分两类看
破解循环,靠的不是再修一批正则,而是想清楚一个朴素的问题:规则到底对哪些字段可靠?为什么?
把108份PDF的失败案例摊开看,答案自己浮出来了。报关单PDF的版式差异,本质是排版的差异:这个字段在上一行还是下一行、标签和值隔多远、是逐字符渲染还是图形渲染。但报关单的标签行本身是海关规定死的,所有版式都一样:
件数 毛重(千克) 净重(千克) 成交方式 运费 保费 杂费
这一行,无论哪个报关行、哪个关区、哪套打印系统打出来的PDF,标签都是这几个字,顺序都一样。规则从这行提取"件数、毛重、净重",跟版式没关系——它天然跨版式可靠。
而商品名称、境内货源地、指运港这些字段,位置随版式千变万化,规则只能靠猜。这类字段,规则不可靠,AI可靠。
所以结论很干脆:
字段类型
例子
处理策略
文本内容字段
商品名称、境内货源地、指运港、备注
纯AI,规则不补全不覆盖
固定标签数值字段
件数、毛重、净重、申报日期、集装箱号
规则兜底(AI空补全/冲突规则优先)
规则没有退出生产链,但被圈定在了它真正可靠的字段上。这就是"精准分层"。
四、三项改造
改造一:精准分层,规则只碰它可靠的字段
代码上,定义了两张"信任清单"——ruleTrustedHeaderFields(件数、毛重、净重、申报日期、集装箱号、信用代码)和 ruleTrustedBodyFields(申报数量、法定数量)。只有清单内的字段,规则才允许补全和覆盖;清单外的字段,一律纯AI,规则不碰。
这套清单的价值在于:它是一次性的架构决策,不是"遇到新格式加一条规则"。以后来任何新版式,只要它的"件数 毛重(千克) 净重(千克)"标签行还在(海关标准格式,必然在),数值字段就稳;文本字段交给AI,也稳。
改造二:Prompt增强,把踩过的坑教给AI
原来的系统提示词只是列字段名:"表头: 订单号,报关单,..."。升级后,提示词变成了"报关单解析专家"角色,并内置了7条实测归纳的易错点:
- 件数:是包装件数(如716),不是表体项数,不要填1
- 毛重:毛重≥净重,不要混淆
- 总价:是金额(如35770.69),不是境内货源地代码(如32259)
- 申报日期:取"申报日期"列,不要取"出口日期"
- 出口口岸:取"离境口岸"名(如外高桥),不要取"出境关别"关名(如外港海关)
- 集装箱号:只保留4字母+7数字,去掉"*1(2)"后缀
- 找不到的字段填"",严禁编造
这7条每一条都对应一个真实的失败案例。AI读过之后,知识型错误肉眼可见地减少:出口口岸13份文件全部取对,集装箱号后缀问题清零。
改造三:合理性校验,只报警不插手
AI偶尔还是会犯迷糊,拦不住。所以我们加了一个静态校验器:毛重<净重、件数=1但毛重>100kg、口岸以"海关"结尾、集装箱号格式不对,这些可疑情况只记录告警日志,不修改结果。
为什么只报警不修改?因为校验逻辑必须和版式无关——一旦"校验"变成"提取",就又回到了改规则的老路。报警的价值是:AI二次自校验(下阶段计划)可以精准地针对告警字段复核,人工复核也有据可依。
五、108份PDF实测
改造完成,用全部108份PDF(覆盖标准格式、图形标签型、多表体项、预放委、预录单、混合多页等所有已知版式)做了全量回归:
指标
结果
AI解析成功率
108/108(100%)
规则信任字段(件数/毛重/净重/申报日期/集装箱号/信用代码)
AI与规则一致 646/646(100%)
商品名称异常(空或纯数字)
0/147
境内货源地/出口口岸补全
23/23(100%)
异常/差异文件
0
AI平均耗时
约4秒/份(并发6)
有几个细节值得单独说。图形标签型PDF("币制(欧元)识别不出来.pdf")里,规则引擎对币制字段完全失效,AI直接提取出"欧元"——这正是当初AI主解析要解决的核心场景。多表体项文件里,规则引擎把境内货源地代码32259当总价,AI给的是104.8、18955.58这样的真实金额。
更重要的变化在维护层面:这次改造之后,我们没有为任何一份新PDF加过一条规则。
六、写在最后
从Python版到Go重构版V2,是"规则为主"到"AI为主"的转变;从V2到V3,是"AI为主但规则乱插手"到"AI为主、规则精准兜底"的收敛。两次升级,同一个感悟:架构设计决定了系统的天花板,而最难的架构决策往往不是加法,而是想清楚"谁该退出"。
V2的问题不是AI不强,也不是规则没用,而是规则用错了地方。把规则从它不擅长的文本字段里撤出来,圈定在它真正可靠的数值字段上,系统立刻从"每来一批新版式就改一轮规则",变成了"新版式零适配"。
如果你也在做报关单、发票、合同这类"版式百花齐放"的文档解析,被"不断改规则"折磨过,这套"文本字段纯AI + 固定标签字段规则兜底"的精准分层思路,可以直接抄作业。
技术栈:Go + Gin + SQLite + DeepSeek AI + kzhpdf(PyMuPDF) 双提取器支持平台:Windows / Linux 双平台
温馨提示
知识产权声明:本软件已获国家版权局软件著作权登记(登记号:2022SR0558725),受《计算机软件保护条例》保护。未经书面授权,严禁对本软件进行反向工程、反编译、破解或任何形式的篡改。侵权必究。
官方指引:本文档为官方安装部署说明,仅适用于当前发布版本,后续版本请以最新官方文档为准。
环境要求:安装前请确认操作系统版本、运行环境(如 .NET、Java 等)及硬件配置满足软件运行要求,避免因环境不兼容导致异常。
操作风险与免责:安装配置涉及防火墙、注册表或环境变量等系统级变更,建议由具备相关经验的技术人员操作。因用户未严格遵循本官方指引或操作不当导致的任何数据丢失、系统异常或其他损失,我方不承担相关责任。如遇问题,请及时联系技术支持。
反馈渠道:如有未覆盖的问题,欢迎通过客服反馈,我们将持续更新与改进。
版本记录:最后更新于 2026-08-22